线性支持向量机的软间隔最大化模型


在线性支持向量机中,我们对线性可分SVM的模型和损失函数优化做了总结。最后我们提到了有时候不能线性可分的原因是线性数据集里面多了少量的异常点,由于这些异常点导致了数据集不能线性可分,本篇就对线性支持向量机如何处理这些异常点的原理方法做一个总结。

1. 线性分类SVM面临的问题

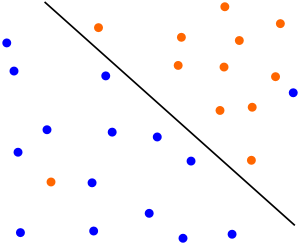
有时候本来数据的确是可分的,也就是说可以用 线性分类SVM的学习方法来求解,但是却因为混入了异常点,导致不能线性可分,比如下图,本来数据是可以按下面的实线来做超平面分离的,可以由于一个橙色和一个蓝色的异常点导致我们没法按照上一篇线性支持向量机中的方法来分类。
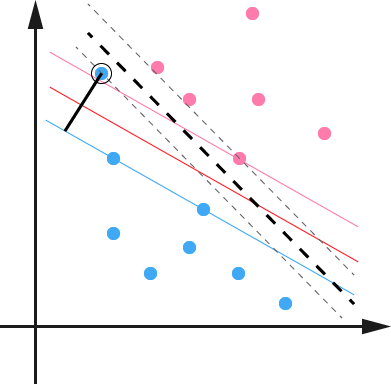
另外一种情况没有这么糟糕到不可分,但是会严重影响我们模型的泛化预测效果,比如下图,本来如果我们不考虑异常点,SVM的超平面应该是下图中的红色线所示,但是由于有一个蓝色的异常点,导致我们学习到的超平面是下图中的粗虚线所示,这样会严重影响我们的分类模型预测效果。
如何解决这些问题呢?SVM引入了软间隔最大化的方法来解决。

2. 线性分类SVM的软间隔最大化

所谓的软间隔,是相对于硬间隔说的,我们可以认为上一篇线性分类SVM的学习方法属于硬间隔最大化。

回顾下硬间隔最大化的条件:min12∣∣w∣∣22s.tyi(wTxi+b)≥1(i=1,2,...m)min\;\; \frac{1}{2}||w||_2^2 \;\; s.t \;\; y_i(w^Tx_i + b) \geq 1 (i =1,2,...m)

接着我们再看如何可以软间隔最大化呢?

SVM对训练集里面的每个样本(xi,yi)(x_i,y_i)引入了一个松弛变量ξi≥0\xi_i \geq 0,使函数间隔加上松弛变量大于等于1,也就是说:

yi(w∙xi+b)≥1−ξi y_i(w\bullet x_i +b) \geq 1- \xi_i

对比硬间隔最大化,可以看到我们对样本到超平面的函数距离的要求放松了,之前是一定要大于等于1,现在只需要加上一个大于等于0的松弛变量能大于等于1就可以了。当然,松弛变量不能白加,这是有成本的,每一个松弛变量ξi\xi_i, 对应了一个代价ξi\xi_i,这个就得到了我们的软间隔最大化的SVM学习条件如下:

min12∣∣w∣∣22+C∑i=1mξis.t.yi(wTxi+b)≥1−ξi(i=1,2,...m)ξi≥0(i=1,2,...m) min\;\; \frac{1}{2}||w||_2^2 +C\sum\limits_{i=1}^{m}\xi_is.t. \;\; y_i(w^Tx_i + b) \geq 1 - \xi_i \;\;(i =1,2,...m)\xi_i \geq 0 \;\;(i =1,2,...m)

这里,C>0为惩罚参数,可以理解为我们一般回归和分类问题正则化时候的参数。C越大,对误分类的惩罚越大,C越小,对误分类的惩罚越小。

也就是说,我们希望12∣∣w∣∣22\frac{1}{2}||w||_2^2尽量小,误分类的点尽可能的少。C是协调两者关系的正则化惩罚系数。在实际应用中,需要调参来选择。

这个目标函数的优化和上一篇的线性可分SVM的优化方式类似,我们下面就来看看怎么对线性分类SVM的软间隔最大化来进行学习优化。

3. 线性分类SVM的软间隔最大化目标函数的优化

和线性可分SVM的优化方式类似,我们首先将软间隔最大化的约束问题用拉格朗日函数转化为无约束问题如下:L(w,b,ξ,α,μ)=12∣∣w∣∣22+C∑i=1mξi−∑i=1mαi[yi(wTxi+b)−1+ξi]−∑i=1mμiξiL(w,b,\xi,\alpha,\mu) = \frac{1}{2}||w||_2^2 +C\sum\limits_{i=1}^{m}\xi_i - \sum\limits_{i=1}^{m}\alpha_i[y_i(w^Tx_i + b) - 1 + \xi_i] - \sum\limits_{i=1}^{m}\mu_i\xi_i

其中μi≥0\mu_i \geq 0, αi≥0\alpha_i \geq 0,均为拉格朗日系数。

也就是说,我们现在要优化的目标函数是:

min(w,b,ξ)(max(αi≥0,μi≥0,)(L(w,b,α,ξ,μ))) min(w,b,\xi)(\; max(\alpha_i \geq 0, \mu_i \geq 0,)( L(w,b,\alpha, \xi,\mu)))

这个优化目标也满足KKT条件,也就是说,我们可以通过拉格朗日对偶将我们的优化问题转化为等价的对偶问题来求解如下:

max(αi≥0,μi≥0,)(min(w,b,ξ)(L(w,b,α,ξ,μ))) max(\alpha_i \geq 0, \mu_i \geq 0,)(\;\; min(w,b,\xi)(\;\; L(w,b,\alpha, \xi,\mu)))

我们可以先求优化函数对于w, b, ξ\xi的极小值, 接着再求拉格朗日乘子α\alpha和μ\mu的极大值。

首先我们来求优化函数对于w, b, ξ\xi的极小值,这个可以通过求偏导数求得:

∂L∂w=0⇒w=∑i=1mαiyixi \frac{\partial L}{\partial w} = 0 \;\Rightarrow w = \sum\limits_{i=1}^{m}\alpha_iy_ix_i

∂L∂b=0⇒∑i=1mαiyi=0 \frac{\partial L}{\partial b} = 0 \;\Rightarrow \sum\limits_{i=1}^{m}\alpha_iy_i = 0

∂L∂ξ=0⇒C−αi−μi=0 \frac{\partial L}{\partial \xi} = 0 \;\Rightarrow C- \alpha_i - \mu_i = 0

好了,我们可以利用上面的三个式子去消除w和b了。

L(w,b,ξ,α,μ)=12∣∣w∣∣22+C∑i=1mξi−∑i=1mαi[yi(wTxi+b)−1+ξi]−∑i=1mμiξi=12∣∣w∣∣22−∑i=1mαi[yi(wTxi+b)−1+ξi]+∑i=1mαiξi=12∣∣w∣∣22−∑i=1mαi[yi(wTxi+b)−1]=12wTw−∑i=1mαiyiwTxi−∑i=1mαiyib+∑i=1mαi=12wT∑i=1mαiyixi−∑i=1mαiyiwTxi−∑i=1mαiyib+∑i=1mαi=12wT∑i=1mαiyixi−wT∑i=1mαiyixi−∑i=1mαiyib+∑i=1mαi=−12wT∑i=1mαiyixi−∑i=1mαiyib+∑i=1mαi=−12wT∑i=1mαiyixi−b∑i=1mαiyi+∑i=1mαi=−12(∑i=1mαiyixi)T(∑i=1mαiyixi)−b∑i=1mαiyi+∑i=1mαi=−12∑i=1mαiyixiT∑i=1mαiyixi−b∑i=1mαiyi+∑i=1mαi=−12∑i=1mαiyixiT∑i=1mαiyixi+∑i=1mαi=−12∑i=1,j=1mαiyixiTαjyjxj+∑i=1mαi=∑i=1mαi−12∑i=1,j=1mαiαjyiyjxiTxj \begin{aligned} L(w,b,\xi,\alpha,\mu) & = \frac{1}{2}||w||_2^2 +C\sum\limits_{i=1}^{m}\xi_i - \sum\limits_{i=1}^{m}\alpha_i[y_i(w^Tx_i + b) - 1 + \xi_i] - \sum\limits_{i=1}^{m}\mu_i\xi_i \\&= \frac{1}{2}||w||_2^2 - \sum\limits_{i=1}^{m}\alpha_i[y_i(w^Tx_i + b) - 1 + \xi_i] + \sum\limits_{i=1}^{m}\alpha_i\xi_i \\& = \frac{1}{2}||w||_2^2 - \sum\limits_{i=1}^{m}\alpha_i[y_i(w^Tx_i + b) - 1] \\& = \frac{1}{2}w^Tw-\sum\limits_{i=1}^{m}\alpha_iy_iw^Tx_i - \sum\limits_{i=1}^{m}\alpha_iy_ib + \sum\limits_{i=1}^{m}\alpha_i \\& = \frac{1}{2}w^T\sum\limits_{i=1}^{m}\alpha_iy_ix_i -\sum\limits_{i=1}^{m}\alpha_iy_iw^Tx_i - \sum\limits_{i=1}^{m}\alpha_iy_ib + \sum\limits_{i=1}^{m}\alpha_i \\& = \frac{1}{2}w^T\sum\limits_{i=1}^{m}\alpha_iy_ix_i - w^T\sum\limits_{i=1}^{m}\alpha_iy_ix_i - \sum\limits_{i=1}^{m}\alpha_iy_ib + \sum\limits_{i=1}^{m}\alpha_i \\& = - \frac{1}{2}w^T\sum\limits_{i=1}^{m}\alpha_iy_ix_i - \sum\limits_{i=1}^{m}\alpha_iy_ib + \sum\limits_{i=1}^{m}\alpha_i \\& = - \frac{1}{2}w^T\sum\limits_{i=1}^{m}\alpha_iy_ix_i - b\sum\limits_{i=1}^{m}\alpha_iy_i + \sum\limits_{i=1}^{m}\alpha_i \\& = -\frac{1}{2}(\sum\limits_{i=1}^{m}\alpha_iy_ix_i)^T(\sum\limits_{i=1}^{m}\alpha_iy_ix_i) - b\sum\limits_{i=1}^{m}\alpha_iy_i + \sum\limits_{i=1}^{m}\alpha_i \\& = -\frac{1}{2}\sum\limits_{i=1}^{m}\alpha_iy_ix_i^T\sum\limits_{i=1}^{m}\alpha_iy_ix_i - b\sum\limits_{i=1}^{m}\alpha_iy_i + \sum\limits_{i=1}^{m}\alpha_i \\& = -\frac{1}{2}\sum\limits_{i=1}^{m}\alpha_iy_ix_i^T\sum\limits_{i=1}^{m}\alpha_iy_ix_i + \sum\limits_{i=1}^{m}\alpha_i \\& = -\frac{1}{2}\sum\limits_{i=1,j=1}^{m}\alpha_iy_ix_i^T\alpha_jy_jx_j + \sum\limits_{i=1}^{m}\alpha_i \\& = \sum\limits_{i=1}^{m}\alpha_i - \frac{1}{2}\sum\limits_{i=1,j=1}^{m}\alpha_i\alpha_jy_iy_jx_i^Tx_j \end{aligned}

其中,(1)式到(2)式用到了C−αi−μi=0C- \alpha_i - \mu_i = 0, (2)式到(3)式合并了同类项,(3)式到(4)式用到了范数的定义∣∣w∣∣22=wTw||w||_2^2 =w^Tw, (4)式到(5)式用到了上面的w=∑i=1mαiyixiw = \sum\limits_{i=1}^{m}\alpha_iy_ix_i, (5)式到(6)式把和样本无关的wTw^T提前,(6)式到(7)式合并了同类项,(7)式到(8)式把和样本无关的b提前,(8)式到(9)式继续用到w=∑i=1mαiyixiw = \sum\limits_{i=1}^{m}\alpha_iy_ix_i,(9)式到(10)式用到了向量的转置。由于常量的转置是其本身,所有只有向量xix_i被转置,(10)式到(11)式用到了上面的∑i=1mαiyi=0\sum\limits_{i=1}^{m}\alpha_iy_i = 0,(11)式到(12)式使用了(a+b+c+...)(a+b+c+...)=aa+ab+ac+ba+bb+bc+...(a+b+c+...)(a+b+c+...)=aa+ab+ac+ba+bb+bc+...的乘法运算法则,(12)式到(13)式仅仅是位置的调整。

仔细观察可以发现,这个式子和我们上一篇线性可分SVM的一样。唯一不一样的是约束条件。现在我们看看我们的优化目标的数学形式:

max(α)∑i=1mαi−12∑i=1,j=1mαiαjyiyjxiTxj max(\alpha)\;\; \sum\limits_{i=1}^{m}\alpha_i - \frac{1}{2}\sum\limits_{i=1,j=1}^{m}\alpha_i\alpha_jy_iy_jx_i^Tx_j

s.t.∑i=1mαiyi=0 s.t. \; \sum\limits_{i=1}^{m}\alpha_iy_i = 0

C−αi−μi=0 C- \alpha_i - \mu_i = 0

αi≥0(i=1,2,...,m) \alpha_i \geq 0 \;(i =1,2,...,m)

μi≥0(i=1,2,...,m) \mu_i \geq 0 \;(i =1,2,...,m)

对于C−αi−μi=0C- \alpha_i - \mu_i = 0 ,αi≥0\alpha_i \geq 0 ,μi≥0\mu_i \geq 0这3个式子,我们可以消去μi\mu_i,只留下αi\alpha_i,也就是说0≤αi≤C0 \leq \alpha_i \leq C。 同时将优化目标函数变号,求极小值,如下:

min(α)12∑i=1,j=1mαiαjyiyjxiTxj−∑i=1mαi min(\alpha)\;\; \frac{1}{2}\sum\limits_{i=1,j=1}^{m}\alpha_i\alpha_jy_iy_jx_i^Tx_j - \sum\limits_{i=1}^{m}\alpha_i

s.t.∑i=1mαiyi=0 s.t. \; \sum\limits_{i=1}^{m}\alpha_iy_i = 0

0≤αi≤C 0 \leq \alpha_i \leq C

这就是软间隔最大化时的线性可分SVM的优化目标形式,和上一篇的硬间隔最大化的线性可分SVM相比,我们仅仅是多了一个约束条件0≤αi≤C0 \leq \alpha_i \leq C。我们依然可以通过SMO算法来求上式极小化时对应的α\alpha向量就可以求出w和b了。

4. 软间隔最大化时的支持向量

在硬间隔最大化时,支持向量比较简单,就是满足yi(wTxi+b)−1=0y_i(w^Tx_i + b) -1 =0就可以了。根据KKT条件中的对偶互补条件αi∗(yi(wTxi+b)−1)=0\alpha_{i}^{*}(y_i(w^Tx_i + b) - 1) = 0,如果αi∗>0\alpha_{i}^{*}>0则有yi(wTxi+b)=1y_i(w^Tx_i + b) =1即点在支持向量上,否则如果αi∗=0\alpha_{i}^{*}=0则有yi(wTxi+b)≥1y_i(w^Tx_i + b) \geq 1,即样本在支持向量上或者已经被正确分类。

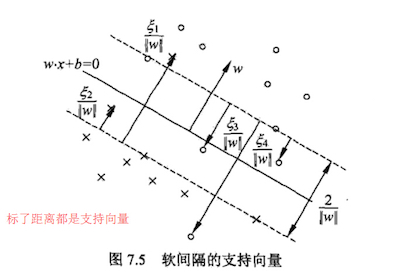
在软间隔最大化时,则稍微复杂一些,因为我们对每个样本(xi,yi)(x_i,y_i)引入了松弛变量ξi\xi_i。我们从下图来研究软间隔最大化时支持向量的情况,第i个点到分类超平面的距离为ξi∣∣w∣∣2\frac{\xi_i}{||w||_2}。根据软间隔最大化时KKT条件中的对偶互补条件αi∗(yi(wTxi+b)−1+ξi∗)=0\alpha_{i}^{*}(y_i(w^Tx_i + b) - 1 + \xi_i^{*}) = 0我们有:

a) 如果α=0\alpha = 0,那么yi(wTxi+b)−1≥0y_i(w^Tx_i + b) - 1 \geq 0,即样本在支持向量上或者已经被正确分类。如图中所有远离支持向量的点。

b) 如果0≤α≤C0 \leq \alpha \leq C,那么ξi=0,yi(wTxi+b)−1=0\xi_i = 0 ,\;\; y_i(w^Tx_i + b) - 1 = 0,即点在支持向量上。如图中在虚线支持向量上的点。

c) 如果α=C\alpha = C,说明这是一个可能比较异常的点,需要检查此时\xi_i

i)如果0≤ξi≤10 \leq \xi_i \leq 1,那么点被正确分类,但是却在超平面和自己类别的支持向量之间。如图中的样本2和4.

ii)如果ξi=1\xi_i =1,那么点在分离超平面上,无法被正确分类。

iii)如果ξi>1\xi_i > 1,那么点在超平面的另一侧,也就是说,这个点不能被正常分类。如图中的样本1和3.
5. 软间隔最大化的线性可分SVM的算法过程

这里我们对软间隔最大化时的线性可分SVM的算法过程做一个总结。

输入是线性可分的m个样本(x1,y1),(x2,y2),...,(xm,ym),{(x_1,y_1), (x_2,y_2), ..., (x_m,y_m),},其中x为n维特征向量。y为二元输出,值为1,或者-1.

输出是分离超平面的参数和b^{*}和分类决策函数。

算法过程如下:1)选择一个惩罚系数C>0, 构造约束优化问题

min(α)12∑i=1,j=1mαiαjyiyjxiTxj−∑i=1mαi min(\alpha)\;\; \frac{1}{2}\sum\limits_{i=1,j=1}^{m}\alpha_i\alpha_jy_iy_jx_i^Tx_j - \sum\limits_{i=1}^{m}\alpha_i

s.t.∑i=1mαiyi=0 s.t. \; \sum\limits_{i=1}^{m}\alpha_iy_i = 0

0≤αi≤C 0 \leq \alpha_i \leq C

2)用SMO算法求出上式最小时对应的\alpha向量的值α∗\alpha^{*}向量.

3) 计算w∗=∑i=1mαi∗yixiw^{*} = \sum\limits_{i=1}^{m}\alpha_i^{*}y_ix_i

4) 找出所有的S个支持向量,即满足0<αs<C0 < \alpha_s < C对应的样本(xs,ys)(x_s,y_s),通过 ys(∑i=1SαiyixiTxs+b)=1y_s(\sum\limits_{i=1}^{S}\alpha_iy_ix_i^Tx_s+b) = 1,计算出每个支持向量(xx,ys)(x_x, y_s)对应的bs∗b_s^{*},计算出这些bs∗=ys−∑i=1SαiyixiTxsb_s^{*} = y_s - \sum\limits_{i=1}^{S}\alpha_iy_ix_i^Tx_s. 所有的bs∗b_s^{*}对应的平均值即为最终的b∗=1S∑i=1Sbs∗b^{*} = \frac{1}{S}\sum\limits_{i=1}^{S}b_s^{*}

这样最终的分类超平面为:w∗∙x+b∗=0w^{*} \bullet x + b^{*} = 0,最终的分类决策函数为:f(x)=sign(w∗∙x+b∗)f(x) = sign(w^{*} \bullet x + b^{*})

6. 合页损失函数

线性支持向量机还有另外一种解释如下:

min(w,b)[1−yi(w∙x+b)]++λ∣∣w∣∣22 min(w, b)\;\;[1-y_i(w \bullet x + b)]_{+} + \lambda ||w||_2^2

其中L(y(w∙x+b))=[1−yi(w∙x+b)]+L(y(w \bullet x + b)) = [1-y_i(w \bullet x + b)]_{+}称为合页损失函数(hinge loss function),下标+表示为:

[z]+={zz>00z≤0[z]_{+}= \begin{cases} z & {z >0}\\ 0& {z\leq 0} \end{cases}

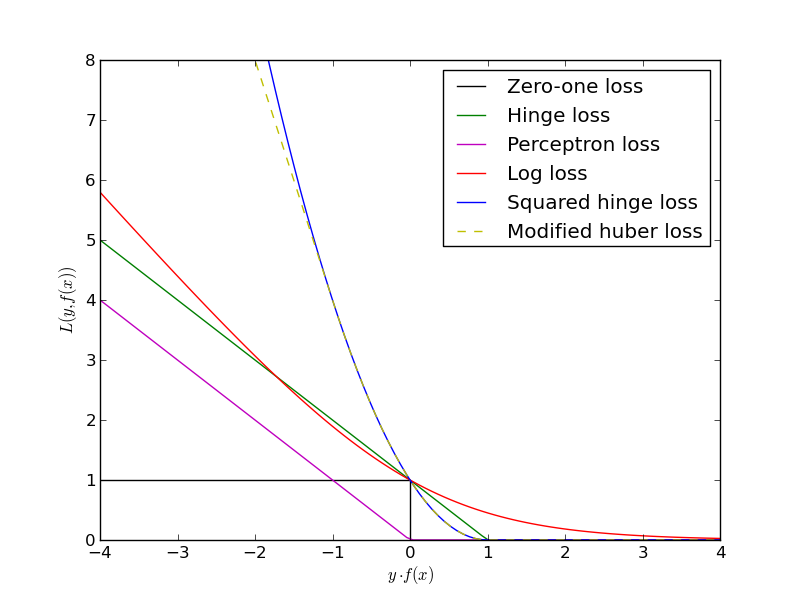
也就是说,如果点被正确分类,且函数间隔大于1,损失是0,否则损失是1−y(w∙x+b)1-y(w \bullet x + b),如下图中的绿线。我们在下图还可以看出其他各种模型损失和函数间隔的关系:对于0-1损失函数,如果正确分类,损失是0,误分类损失1, 如下图黑线,可见0-1损失函数是不可导的。对于感知机模型,感知机的损失函数是[−yi(w∙x+b)]+[-y_i(w \bullet x + b)]_{+},这样当样本被正确分类时,损失是0,误分类时,损失是-yi(w∙x+b)y_i(w \bullet x + b),如下图紫线。对于逻辑回归之类和最大熵模型对应的对数损失,损失函数是log[1+exp(−y(w∙x+b))]log[1+exp(-y(w \bullet x + b))], 如下图红线所示。

线性可分SVM通过软间隔最大化,可以解决线性数据集带有异常点时的分类处理,但是现实生活中的确有很多数据不是线性可分的,这些线性不可分的数据也不是去掉异常点就能处理这么简单。那么SVM怎么能处理中这样的情况呢?我们在下一篇就来讨论线性不可分SVM和核函数的原理。

results matching ""

    No results matching ""